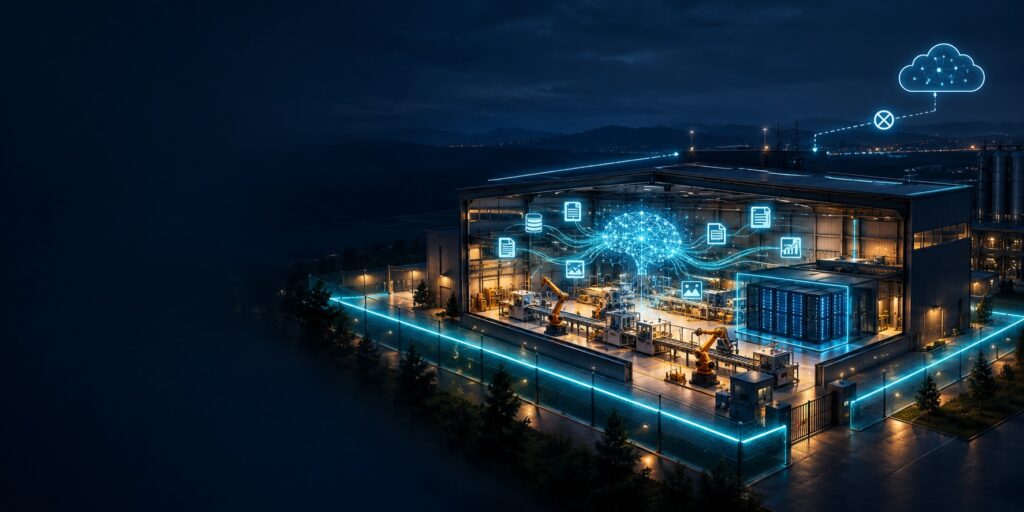
问一位厂长:维修班组能不能把故障代码和一页手册的照片贴到公共聊天机器人里?你通常会得到两种回答之一:"当然可以"或"绝对不行"。这两种回答往往错在同一处:没人真正决定过哪类信息属于哪一边。
在自己楼里的服务器上跑语言模型,早已不是难点。一块中端显卡就能跑起实用的开源权重模型,Ollama、llama.cpp、vLLM 等工具也已成熟。难点是三个问题:
- 哪些工厂数据绝不能出厂,哪些可以?
- 模型相对于工厂网络应该放在哪里?
- 如何向自己和前来审核的客户证明没有数据外流?
显卡与内存如何选型,我们已有单独文章:本地大模型硬件选型指南(英文),这里不再重复。
1. 先把数据分成三类
选模型之前,先给模型将要看到的数据分级:
| 类别 | 例子 | 可在哪里处理 |
|---|---|---|
| 可以外发 | 公开数据手册、通用维修知识 | 共享云 API 也可以 |
| 有合同才可 | 内部 SOP、重要性较低的报告 | 自己云账号内的云服务,并有"不用于训练"的书面承诺 |
| 绝不出厂 | 客户图纸、工艺配方、测量与质量数据、模具夹具细节、一切受客户保密协议约束的内容 | 仅限自有基础设施 |
第三类正是工厂与办公室的最大差别。对精密零件厂来说,图纸、公差和工艺参数本身就是产品。
如果你是日本客户或跨国企业的供应商,还有一点值得留意:按日本的商业秘密框架,把信息交给生成式 AI 服务商这类第三方,在某些情况下可能动摇商业秘密所依赖的"保密管理"。也有解读称,日本主管部门2026年6月的指引强调,持有对方机密信息的一方,未经对方事先明确同意不应向第三方披露。所以应检查你的保密协议是否把"AI 服务"视为第三方。(以上来自二手解读,不构成法律意见,请核对原文并咨询律师。)
控制强度由松到紧:
- 共享的外部 API
- 带"不训练"合同的共享 API
- 在自己云订阅内的托管部署
- 自有硬件(必要时物理隔离)
"绝不出厂"的数据需要第 4 级,这就是本地大模型存在的理由。
2. 车间里的模型到底适合干什么
期望要务实。8B–30B 量级的本地模型擅长基于你自己文档的语言类工作,但它不是无所不知的先知。
适合
- 带出处的维修问答:"这个主轴罩的拧紧力矩是多少?"从手册回答并指出页码
- 根据历史工单解释故障代码和报警
- 起草文档:交接班记录、把技工的口述整理成结构化工单、事件摘要
- 在中日泰英混杂的文档里检索(关键词搜索失效的场景)
不适合
- 向 PLC 或控制系统写入。模型保持只读,任何操作必须由人批准
- 无法验证的数值推理(计算交给代码,不要交给模型)
- 没有出处的断言式回答(引不出文档就当作建议)
3. 放在哪里:远离控制网络
flowchart TD
  A["控制网络 PLC和设备"] --> B["只读数据网关"]
  B --> C["工厂数据区 历史库和MES"]
  C --> D["AI区 LLM服务器和文档索引"]
  E["手册 SOP 和工单"] --> D
  D --> F["办公室或车间用户"]
  D --> G["每次提问与回答的审计日志"]
  H["互联网"] -.->|"默认阻断"| D
比选模型更重要的设计规则:
- 只从下往上读。AI 区可通过网关读取工厂数据,但不得有任何内容回流到控制网络。
- 出站默认拒绝。LLM 服务器不应有通往互联网的路由;模型和更新通过受控的离线方式导入。
- 记录每次提问和回答,并附所引用的文档片段,这就是审计轨迹。
- 操作由人批准。模型建议,人决定。
4. 如何证明"没有出去"
"数据不出楼"是一种主张,客户和审核方要的是证据:
- 防火墙证据:AI 区的出站默认拒绝规则,导出规则集供评审。
- 实测流量:抓取一个有代表性的星期内 LLM 服务器的流量,证明没有连向意外的目的地。每次软件升级后重做。
- 离线供应链:记录模型权重来源,导入时校验哈希,固定版本。框架在版本之间会改默认值,升级后要重新测试。
- 排除隐蔽遥测:检查运行时和各个库的配置里有无更新检查或使用数据上报,关闭或在防火墙处拦截。
5. 容量一段话
对少数人的交互使用,单块 24 GB 显卡可从容运行 7B–14B 模型;4 位量化下也能跑 27B–32B,但要为上下文留出余量(在权重之外预留 20–30% 显存)。真正的瓶颈通常是并发数和上下文长度,而不是模型质量。如果二十名技工同时提问,就需要擅长批处理的推理栈或更多硬件。
6. 我们已交付什么,什么属于项目工作
为保持诚实,明确区分:
- simpliSOC 中已交付:本地大模型读取符合条件的安全告警,给出通俗说明和真/误报判断。可对接任何兼容 OpenAI 接口的服务器(Ollama、llama.cpp、vLLM、LocalAI)。模型在本地运行,告警内容不离开你的网络。它只辅助分诊,绝不自动关闭、合并或抑制告警,由分析员把关。详见 simpliSOC 页面(英文)。这是安全运营工具,不是车间助手。
- 按客户定制的项目工作:面向制造企业的本地大模型服务(模型选型、兼容 OpenAI 的 API 层、基于手册与生产记录的 RAG、护栏与审计日志、对接 ERP/MES)。见 simpliLLM(英文)。它以项目方式交付,而非盒装产品,范围和周期取决于你的文档与硬件。
检索部分可参考面向泰语和日语业务文档的生产级 RAG(英文),上线风险可参考 AI security in production(英文)。
7. 常见问题(FAQ)
本地模型和云端模型一样好吗?
顶级云端模型更强。但对手册查询、起草这类基于文档的任务,喂好文档的小模型往往够用。请用你自己的文档和问题测试,而不是看公开榜单。
"本地"就等于"安全"吗?
不等于。它只消除了"数据交给第三方"这一项风险;权限控制、补丁、网络分段和日志仍然需要。
能让模型直接控制设备吗?
不建议。保持只读,操作由人批准。
一定要 GPU 吗?
认真使用就需要。仅 CPU 可以给单用户跑小模型,但速度慢。
能处理泰、日、中文文档吗?
质量随模型和文档类型而异(扫描件、表格和图纸更难)。在买硬件之前,先用真实文档样本评估。
这是关于保密协议和商业秘密的法律意见吗?
不是。请核对合同并咨询律师。
参考资料
- Timewell:图纸、生成式 AI 与商业秘密的边界(日本指引解读)
- iFactory:面向工厂的本地大模型架构(厂商博客,仅作用例参考)
- IntuitionLabs:24 GB 显卡上的本地大模型部署
Simplico Co., Ltd. 为泰国、日本及亚洲企业提供私有化 AI、SOC 与制造业系统开发。联系:hello@simplico.net
最新文章
- 日本《主动网络防御法》已生效:关键基础设施运营商的供应商,前30天应准备好哪些检测、证据与报告能力 October 13, 2026
- 在泰国找斯巴鲁服务店:一个标明每条信息来源的小工具 October 12, 2026
- simpliRange 早期版上线:为泰国道路打造的电动车长途出行规划工具,欢迎试用并告诉我们哪里不准 October 8, 2026
- 电量够不够撑到下一个充电桩?一款为泰国道路打造的电动车长途出行规划 App 构想,在开发之前我们想先听你的意见 October 6, 2026
- 签证、90天报到、车辆税、护照:一个帮你记住所有到期日的 App 构想,在开发之前我们想先听你的意见 October 5, 2026
- 妈妈今天还好吗?”——一款每日问安的养老 App 构想,在动手开发之前,我们想先听听你的意见 October 5, 2026