厂里最好的编程师傅已经干了二十年。某个客户的检验规程,存放在共享盘里的一份PDF中,只有三个人知道怎么找到。昨晚收到的询价单(RFQ),是一个和两年前报过价的零件很像的件,可没有人记得当时实际做下来成本是多少。
这类问题,大语言模型(LLM)能帮上忙。可是,这类问题里最容易想到的工具,也就是公开的AI聊天服务,带着一个多数工厂还没有想清楚的风险:客户的图纸,并不是你可以随意共享的。
这篇文章写给正在权衡本地大模型(跑在你自己的硬件上、你自己的网络里)的数控加工厂和模具厂的老板与管理者。我们会讲它在哪里有用、应该让它远离哪里,以及在真正投钱之前怎样先测试。
为什么“本地”对加工厂和模具厂很重要
图纸或CAD模型会告诉读者很多东西:几何形状、公差,以及关于这个零件是如何制造的大量线索。这就是客户要在保密协议(NDA)约束下才发送的原因,也是有一家制造业交易平台提醒大家通用的NDA模板很难保护好CAD文件的原因。它的建议是:在协议里写明文件类型,并核实文件是怎么存放的、谁能查看、什么时候删除。
把这一点套到AI上。如果程序员把客户图纸上的备注粘贴进一个公开的聊天服务,这些信息就已经离开了你的网络,到了第三方手里。这是否违反某份具体的NDA,取决于它的措辞,而我们不是律师。但这个问题应该在第一次粘贴之前问,而不是之后。我们没有找到能够明确回答“在常见NDA下应如何看待公开AI服务”的资料,所以请读一读你自己的合同;拿不准时,去问你的客户。
本地大模型用一种简单的方式回答了这个问题:数据不出厂房。这是自己部署的主要理由,但它本身并不构成购买的理由,下文也会说明什么时候云服务反而更合理。
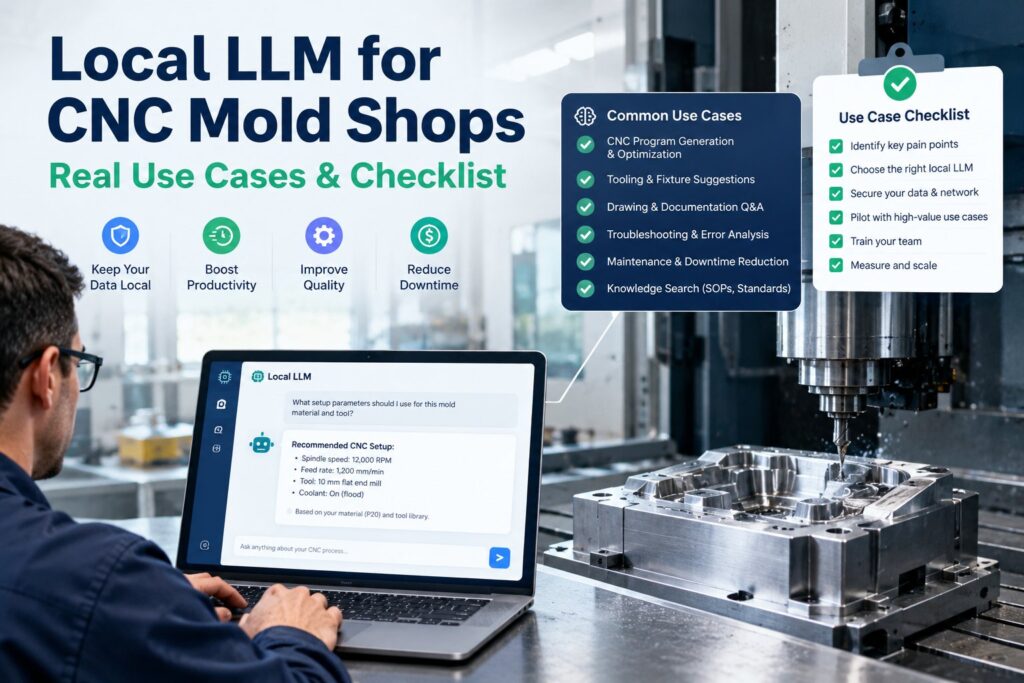
本地大模型在加工厂和模具厂擅长什么
下面这些工作,语言模型确实能派上用场。它们全都是关于文字的,而不是关于切削金属的。
- 用日常语言检索自己的文档。 作业指导书、检验规程、客户规格书、质量手册、过往的不合格报告和刀具笔记。不用再在文件夹里翻找,而是直接问“客户X那个壳体的检验频率是多少?”,然后得到一个带原文页面链接的答案。这通常叫检索增强生成(RAG):模型是根据你的文档回答,而不是凭它的通用记忆。
- 辅助报价。 找出有相似特征的历史订单,总结当时的成本和出过的问题,起草给客户的回复。定价仍然由报价员决定。
- 翻译与摘要。 用日语、中文、英语或泰语发来的邮件、规格书和变更通知,需要让读另一种语言的人也能看懂。对于服务多语种客户的工厂,这往往是人们最先感受到省时间的工作。
- 沉淀经验。 资深师傅或程序员把某个决定的理由讲出来,写下来并可检索,这样即使这个人退休了,经验也留得住。这件事既是流程问题,也是技术问题,但可检索的资料库才让它真正有用。
- 用日常语言询问ERP或生产数据。 比如“上个季度客户Y有哪些订单延期,原因是什么?”,前提是你的系统已经打通。
不该让它碰什么
不要在没有人逐行检查的情况下,用大模型生成G代码或刀路。 就连AI编程工具的厂商自己也说,输出只是需要复核的起点。某厂商的指南称输出大约完成了80%,这是厂商自己的说法,而不是实测结果。我们找到的一项小型学术研究,让AI模型对照机床控制面板的截图来检查G代码,共16个测试用例。G代码与面板合并检查的准确率,依提示词设置的不同,大约在63%到75%之间,作者也说明结果是初步的,而且只针对一台车床。这是样本很小的研究结果,但方向是对的:不要把机床的运动交给一个预测文字的模型。
凡是答案错了可能撞刀或伤人的地方,也是一样:被当作事实的进给与转速、安全规程,以及从图纸上读出的公差。语言模型作为文档的读者很有用,但它不是测量仪器。
专门的CAM类AI产品是存在的,它们和通用大模型是不同的类别:在CAM软件内部运行,使用你的刀具库。如果编程时间是你的瓶颈,请就这些产品本身的价值去评估,并自己测量结果。
运行它需要什么
不需要数据中心。根据一篇硬件科普文章给出的粗略经验值,模型权重在完整的16位精度下,每10亿参数约占2GB内存;压缩(“量化”)到4位后,每10亿参数约占0.6GB。照此推算,一个约300亿参数的中型模型量化后,仅权重就需要大约20GB,而对话上下文和多人同时使用还需要更多。一个700亿参数的模型量化到4位,需要超过40GB。
由此有两点实用的结论。第一,硬件要按同时使用的人数和文档的长度来配置,而不只是看模型。第二,较小的本地模型比人们常拿来比较的大型云端模型要弱。对于带引用的文档检索,这通常可以接受,因为答案来自你自己的页面;对于开放式的推理,别期望太高。
什么时候云服务更合适
如果你想检索的文档并不涉密(公开标准、你自己的宣传资料、通用的培训内容),云服务可能更简单、更便宜。本地系统还需要有人维护。我们宁愿直说,也不想卖给你用不上的硬件。当数据受NDA约束、客户有这样的期望、或者你本来就可能忍不住把受限材料粘贴进公开工具时,再选择本地方案。
在买任何东西之前,先测这五个问题
从过去一个月里取二十个真实的问题,也就是员工真的问过或者很难回答的问题,把它们当作测试题。
- 它是否根据你的文档作答,并给出原文页面? 没有引用的答案,既无法信任,也无法核对。
- 答案不在文档里时,它是否会说“不知道”? 会编造答案的系统,比没有系统更糟。
- 它是否能处理你使用的语言? 包括客户用日语、中文或泰语写的术语。
- 谁能看到哪些文档? 客户A的图纸,不应该出现在回答客户B订单相关人员的答案里。
- 厂里有人能维护吗? 还是说有你负担得起的支持方案?
30天起步计划
第1周:选定一组文档。 选一组大家经常检索、而且你有权使用的文档,比如检验规程或作业指导书。只做一个用例,CAM厂商自己的指南也是这样建议的。
第2周:核对合同。 阅读相关文档所涉客户的NDA,记下对第三方处理或存放的任何限制。
第3周:写好测试题。 收集二十个问题和正确答案,并注明每个答案出自哪一页。
第4周:测试并计数。 答对了多少,来源正确的有多少,信心十足地答错的有多少。这个数字会告诉你要不要继续往下走。
Simplico能做什么
我们为不能把数据发送到公开服务的企业,构建并运行本地部署(on-premise)的大模型系统:安装在你自己的网络内部,提供对你自有文档的检索、护栏(guardrails)和审计日志,在有帮助的地方与你的ERP或生产系统对接。我们自己的服务页面介绍了范围明确的概念验证,大约需要两到三周。我们不声称持有任何认证,也不承诺语言模型会取代你工程工作的任何一部分。
如果你想在联系任何人之前先了解自己准备得怎么样,可以做我们免费的本地大模型就绪度评估:这是一份包含25个问题的自查,涵盖合规、基础设施、用例、集成和组织五个方面。服务详情见simpliLLM页面。
联系我们
告诉我们你的团队最常检索哪些文档,以及客户的NDA是怎么写的,我们会告诉你本地大模型是否合适,还是有更简单的办法。一次简短的沟通就足以开始。
- 邮箱:hello@simplico.net
- LINE:iiitum1984
- 电话:(+66) 97496 6397
常见问题
本地大模型能替我们写G代码吗?
它能生成看起来像G代码的文本,但不应该在没有合格人员逐行检查的情况下用来运行机床。关于可靠性的公开证据很少,而且AI编程工具的厂商自己也说输出需要复核。
把客户图纸上的备注粘贴到公开的AI聊天里安全吗?
这取决于你的NDA和该服务的条款。许多工厂还没有核对过。请阅读合同,措辞不清楚时去问客户。本地系统可以回避这个问题,因为数据留在你自己的网络里。
需要多大的电脑?
取决于模型大小、同时使用的人数和文档的长度。粗略地说,一个量化后的中型模型,仅权重就需要约20GB的GPU显存。请从你的用例出发做规划,而不是从模型名称出发。
它会取代我们的报价员或程序员吗?
不会。它加快的是查找信息和起草文字。关于价格、工艺和安全的判断,仍然在你们的人手里。
我们只有几台机床,值得吗?
大概还不值得,除非你手里有大量受NDA约束的客户文档,而且员工已经在检索上浪费了时间。在花钱之前,先从上面的30天测试开始。
资料来源
- MakerVerse: NDA and IP protection for CAD files(交易平台的文章)
- CloudNC: How to use AI in machining(厂商文章)
- arXiv: Few-shot VLM-based G-code and HMI verification in CNC machining(预印本,数据集较小)
- Computing for Geeks: How much VRAM to run an LLM(硬件指南)
最新文章
- 潜水店、旅行社与地接社:当聊天软件和电子表格撑不起预订管理时 October 24, 2026
- 为大型物业业主规划充电桩平台:两款车主应用、预付钱包与三级身份验证 October 20, 2026
- 充电桩场地方的难题:怎样让物业、酒店或餐厅看到自己的充电桩后台,又不必再多一个账号 October 17, 2026
- 创作者该推广哪款商品?我们想验证的一个想法 October 14, 2026
- 日本《主动网络防御法》已生效:关键基础设施运营商的供应商,前30天应准备好哪些检测、证据与报告能力 October 13, 2026
- 在泰国找斯巴鲁服务店:一个标明每条信息来源的小工具 October 12, 2026